Robots.txt
Robots.txt to plik tekstowy umieszczany w głównym katalogu domeny, który przekazuje robotom internetowym informacje o tym, do których zasobów witryny powinny lub nie powinny uzyskiwać dostępu podczas crawlowania. Jest wykorzystywany przede wszystkim do zarządzania ruchem robotów wyszukiwarek i ograniczania skanowania wybranych sekcji serwisu. Plik jest odczytywany między innymi przez roboty wyszukiwarek przed rozpoczęciem pobierania zawartości strony.
Robots.txt nie służy bezpośrednio do usuwania stron z indeksu wyszukiwarki. Dyrektywa blokująca dostęp do adresu URL może ograniczyć jego crawlowanie, ale sam adres w określonych sytuacjach nadal może pojawić się w wynikach wyszukiwania, jeśli wyszukiwarka pozna go z innych źródeł. Z tego powodu plik powinien być stosowany świadomie i zgodnie z jego podstawową funkcją, czyli kontrolowaniem dostępu robotów do zasobów.
Spis treści
Jak działa plik robots.txt?
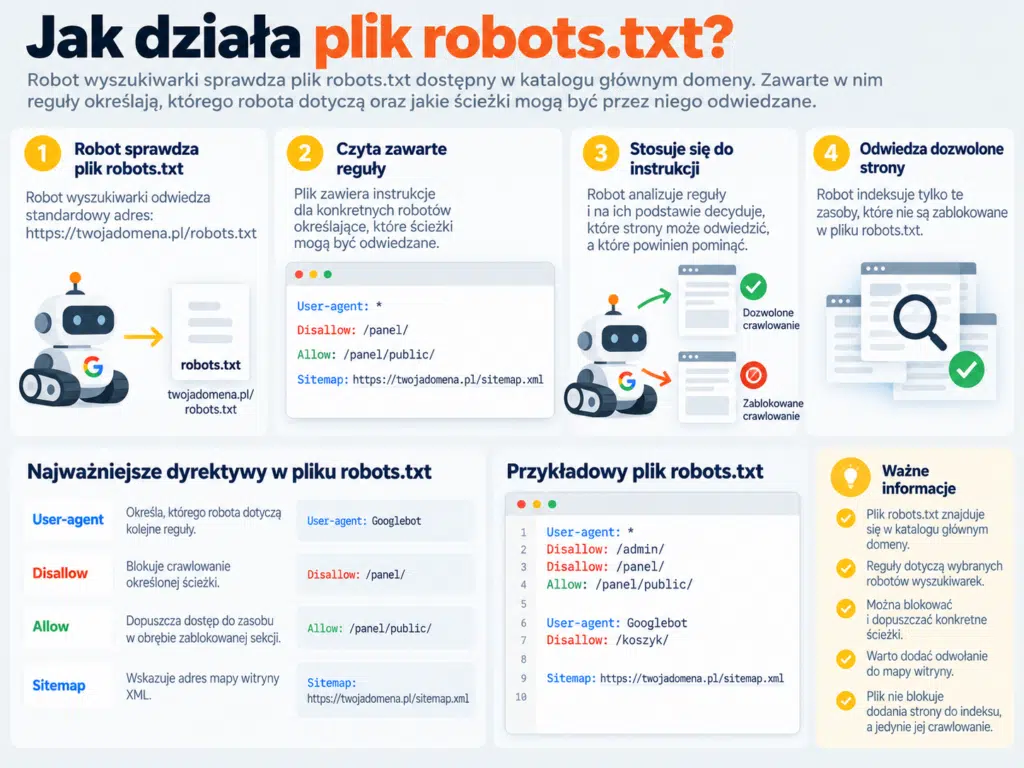
Robot wyszukiwarki zwykle sprawdza plik robots.txt dostępny pod standardowym adresem w katalogu głównym domeny. Zawarte w nim reguły określają, którego robota dotyczą oraz jakie ścieżki mogą być przez niego odwiedzane. Do najczęściej stosowanych elementów należą dyrektywy User-agent, Disallow i Allow.
Reguła User-agent wskazuje robota, dla którego przygotowano zestaw instrukcji, natomiast Disallow może blokować crawlowanie określonej ścieżki. Allow służy do dopuszczania dostępu do konkretnego zasobu w obrębie szerzej zablokowanej sekcji. Plik może także zawierać odwołanie do mapy witryny poprzez wskazanie jej adresu.
Do czego wykorzystuje się robots.txt w SEO?
Plik pomaga zarządzać sposobem, w jaki roboty wyszukiwarki poruszają się po serwisie. Może ograniczać dostęp do obszarów technicznych, stron wyników wewnętrznego wyszukiwania, wybranych parametrów URL albo innych zasobów, których regularne crawlowanie nie jest potrzebne. Ma to szczególne znaczenie w dużych serwisach, gdzie liczba adresów URL może być bardzo wysoka, a problemem może stać się index bloat, czyli nadmierna liczba mało wartościowych adresów obecnych w indeksie wyszukiwarki.
Odpowiednia konfiguracja może wspierać efektywne wykorzystanie budżetu crawlowania przez ograniczenie pobierania mało istotnych zasobów. Istotna jest przy tym również crawlability strony, czyli możliwość skutecznego docierania robotów wyszukiwarki do jej zasobów. Nie należy jednak blokować przypadkowo plików CSS, JavaScript ani innych elementów potrzebnych wyszukiwarce do prawidłowego renderowania strony. Błędne reguły mogą utrudnić robotom dostęp do wartościowych sekcji i negatywnie wpłynąć na proces analizy witryny.
Czego nie należy blokować w robots.txt?
Blokowanie stron przeznaczonych do pozycjonowania może sprawić, że wyszukiwarka nie będzie mogła regularnie analizować ich zawartości. Szczególnej ostrożności wymagają reguły obejmujące całe katalogi, ponieważ jeden nieprecyzyjny zapis może odciąć robotowi dostęp do dużej części serwisu. Każda zmiana powinna być sprawdzona pod kątem adresów, które rzeczywiście obejmuje.
Robots.txt nie powinien być również traktowany jako mechanizm ochrony poufnych informacji. Plik jest publicznie dostępny, a roboty inne niż te respektujące przyjęty standard mogą zignorować zapisane w nim instrukcje. Dane wymagające ochrony powinny być zabezpieczane za pomocą odpowiednich mechanizmów autoryzacji i kontroli dostępu.
Czym robots.txt różni się od meta robots?
Robots.txt kontroluje przede wszystkim możliwość crawlowania adresów URL, natomiast meta robots pozwala przekazywać instrukcje dotyczące indeksowania konkretnej strony i sposobu obsługi znajdujących się na niej odnośników. Dyrektywy takie jak noindex umieszcza się na poziomie dokumentu HTML lub w odpowiednim nagłówku HTTP, a nie w pliku robots.txt.
Różnica jest istotna przy wykluczaniu stron z wyników wyszukiwania. Jeżeli robot ma zobaczyć dyrektywę noindex, musi mieć możliwość wejścia na daną stronę i jej odczytania. Jednoczesne zablokowanie adresu w robots.txt może uniemożliwić wyszukiwarce odczytanie takiej instrukcji. Nieprawidłowe ustawienia mogą w konsekwencji prowadzić do sytuacji określanej jako błąd indeksowania. W większych serwisach znaczenie ma również crawl depth, ponieważ określa, jak głęboko w strukturze witryny znajduje się dany adres względem punktów wejścia robota.
Najczęstsze pytania (FAQ) Robots.txt
Co to jest robots.txt?
Robots.txt to plik tekstowy informujący roboty internetowe, do których części witryny mogą uzyskiwać dostęp podczas crawlowania. Umieszcza się go w głównym katalogu domeny.
Czy robots.txt usuwa stronę z Google?
Nie. Zablokowanie adresu w robots.txt ogranicza jego crawlowanie, ale nie jest bezpośrednią metodą usuwania go z indeksu. Do kontroli indeksowania wykorzystuje się inne rozwiązania, na przykład dyrektywę noindex.
Co oznacza Disallow w robots.txt?
Disallow wskazuje ścieżkę, której określony robot nie powinien crawlowć. Zakres działania reguły zależy od jej zapisu oraz od sekcji User-agent, do której została przypisana.
Czy każda strona powinna mieć robots.txt?
Nie jest to bezwzględnie konieczne dla każdej witryny, ale plik jest przydatnym narzędziem do zarządzania dostępem robotów. W większych serwisach pomaga uporządkować proces crawlowania i ograniczyć skanowanie zbędnych zasobów.
Ekspert SEO, Google Ads i Meta Ads, pomagający w audytach działań marketingowych i odblokowywaniu kont reklamowych. Sprawdzam skuteczność strategii i wskazuję obszary do poprawy, aby Twój budżet był wykorzystywany efektywnie.